


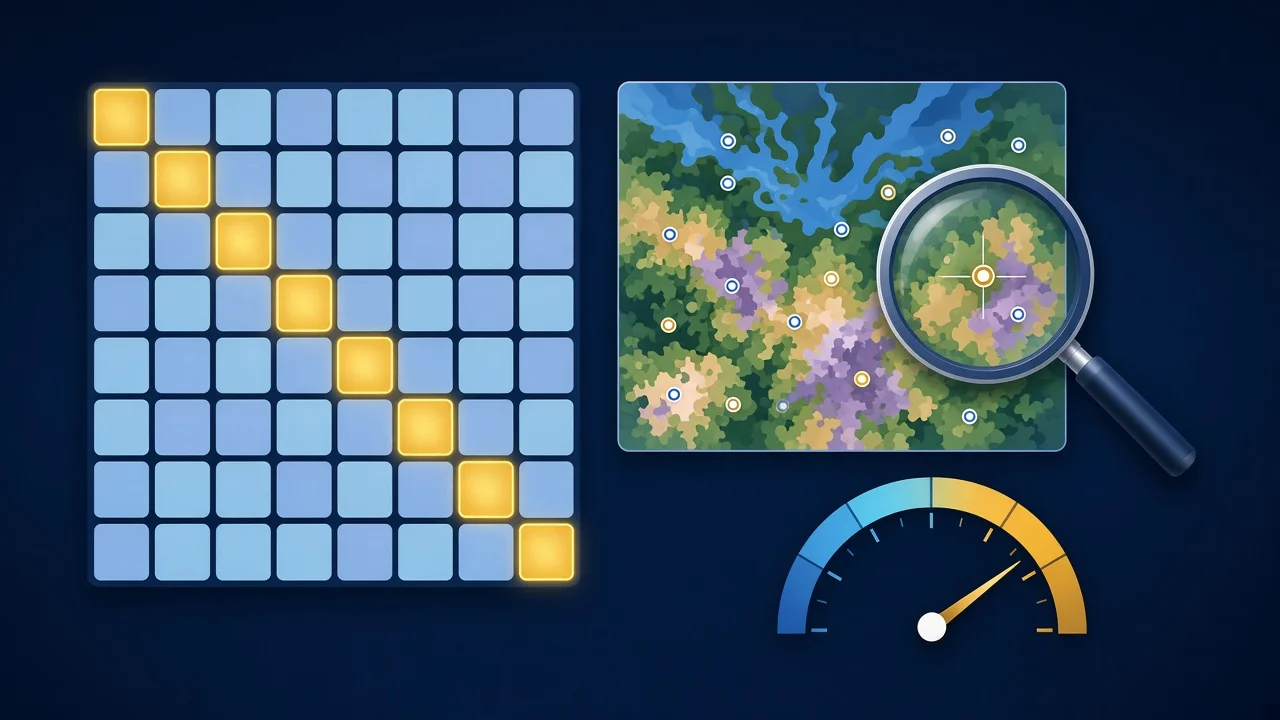
پاسخ کوتاه: ضریب کاپا در سنجش از دور نشان میدهد نقشه طبقهبندیشده شما چقدر بهتر از یک طبقهبندی تصادفی با داده مرجع توافق دارد. فرمول آن K = (Po − Pe) / (1 − Pe) است که Po صحت کلی و Pe توافق مورد انتظار از روی شانس است. کاپای بالای ۰٫۸ توافق قوی، ۰٫۶ تا ۰٫۸ خوب و کمتر از ۰٫۴ ضعیف تلقی میشود. کاپا همیشه باید همراه صحت کلی، صحت کاربر و صحت تولیدکننده گزارش شود.
تقریباً هر پایاننامهای که نقشه کاربری اراضی، پوشش گیاهی یا تغییرات میسازد، جملهای شبیه «صحت کلی ۸۹ درصد و ضریب کاپا ۰٫۸۶ به دست آمد» دارد. اما وقتی داور میپرسد «کاپا را چطور حساب کردید؟ نقاط کنترل از کجا آمد؟ کدام کلاس ضعیف بود؟» بسیاری پاسخی ندارند. منابع فارسی هم معمولاً فیلم کوتاه یا فرمول بدون مثالاند. در این آموزش یک ماتریس خطای واقعینما را قدمبهقدم حل میکنیم، همه شاخصها را محاسبه و تفسیر میکنیم و درباره نقدهای جدی به کاپا هم صحبت میکنیم تا گزارش دقت شما قابل دفاع باشد.
چرا ارزیابی دقت طبقهبندی لازم است؟
هر نقشه طبقهبندیشده خطا دارد: پیکسلهای مخلوط، شباهت طیفی کلاسها، نمونه تعلیمی ناقص و تفاوت زمانی تصویر با واقعیت. ارزیابی دقت به سه سؤال پاسخ میدهد:
- کل نقشه چقدر قابل اعتماد است؟ (صحت کلی و کاپا)
- کدام کلاسها ضعیفاند و با چه کلاسی اشتباه گرفته شدهاند؟ (صحت کاربر، صحت تولیدکننده، ماتریس خطا)
- مساحتهایی که گزارش میکنید چقدر نامطمئناند؟ (برآورد مساحت تعدیلشده)
دقت موضوعی (درستی کلاس) با دقت مکانی (درستی مختصات) فرق دارد. دقت مکانی را با نقاط کنترل زمینی و RMSE میسنجند؛ موضوعی که در راهنمای نقاط کنترل و چکپوینت پهپاد آمده است. اینجا تمرکز ما دقت موضوعی است.
ماتریس خطا (Confusion Matrix) چیست؟
ماتریس خطا جدولی مربعی است که سطرهای آن کلاسهای نقشه (طبقهبندیشده) و ستونهایش کلاسهای مرجع (واقعیت زمینی) هستند؛ برخی نرمافزارها برعکس عمل میکنند، پس همیشه عنوان سطر و ستون را بخوانید. خانههای قطر اصلی نقاطیاند که درست طبقهبندی شدهاند.
- داده مرجع از بازدید میدانی، تصاویر با تفکیک بالا (Google Earth، عکس هوایی، پهپاد) یا نقشههای معتبر میآید.
- نقاط کنترل باید مستقل از نمونههای تعلیمی باشند. اگر از همان پلیگونهای آموزش استفاده کنید، دقت بهطور کاذب بالا میرود (توضیح در اعتبارسنجی متقابل مکانی).
- تعداد: قاعده Congalton حداقل ۵۰ نقطه برای هر کلاس و برای بیش از ۱۲ کلاس یا مناطق بزرگ ۷۵ تا ۱۰۰ نقطه است.
- روش نمونهگیری: تصادفی طبقهبندیشده (Stratified Random) بهترین گزینه است تا کلاسهای کوچک هم نقطه کافی بگیرند.
چند نقطه کنترل کافی است؟ محاسبه با فرمول
به جای عدد حدسی، تعداد کل نقاط را میتوانید با فرمول دوجملهای برآورد کنید: n = z² × p × (1 − p) / E² که در آن z برای اطمینان ۹۵ درصد برابر ۱٫۹۶، p صحت کلی مورد انتظار و E حاشیه خطای قابل قبول است. اگر انتظار صحت ۸۵ درصد و حاشیه خطای ۵ درصد دارید: n = 3.8416 × 0.85 × 0.15 / 0.0025 ≈ 196 نقطه. با حاشیه خطای ۳ درصد این عدد به حدود ۵۴۴ نقطه میرسد. سپس این تعداد را بین کلاسها تقسیم کنید، به شکلی که هیچ کلاسی کمتر از ۵۰ نقطه نگیرد و بقیه به نسبت مساحت توزیع شوند. این محاسبه یک پاراگراف قوی در فصل روش پایاننامه است و داور را از سؤال «چرا ۳۰۰ نقطه؟» بینیاز میکند.
مثال عددی کامل: از ماتریس خطا تا ضریب کاپا
فرض کنید نقشه کاربری اراضی یک دشت را با ۴ کلاس ساختهاید و ۴۰۰ نقطه کنترل مستقل دارید. ماتریس خطا (سطر = نقشه، ستون = مرجع):
| نقشه ↓ / مرجع → | ساختهشده | کشاورزی | مرتع | آب | جمع سطر |
|---|---|---|---|---|---|
| ساختهشده | ۸۵ | ۷ | ۶ | ۲ | ۱۰۰ |
| کشاورزی | ۵ | ۱۱۲ | ۱۰ | ۳ | ۱۳۰ |
| مرتع | ۸ | ۱۵ | ۹۲ | ۰ | ۱۱۵ |
| آب | ۲ | ۱ | ۲ | ۵۰ | ۵۵ |
| جمع ستون | ۱۰۰ | ۱۳۵ | ۱۱۰ | ۵۵ | ۴۰۰ |
گام ۱: صحت کلی (Overall Accuracy)
مجموع قطر اصلی تقسیم بر کل نقاط: Po = (85 + 112 + 92 + 50) / 400 = 339 / 400 = 0.8475، یعنی ۸۴٫۷۵ درصد.
گام ۲: توافق مورد انتظار از روی شانس (Pe)
برای هر کلاس، جمع سطر را در جمع ستون ضرب و مجموع را بر مجذور کل تقسیم کنید:
Pe = (100×100 + 130×135 + 115×110 + 55×55) / 400²
   = (10000 + 17550 + 12650 + 3025) / 160000
   = 43225 / 160000 = 0.2702
یعنی اگر نقشهای با همین نسبت کلاسها بهطور تصادفی ساخته شود، حدود ۲۷ درصد نقاط تصادفاً درست درمیآیند.
گام ۳: ضریب کاپا
K = (0.8475 − 0.2702) / (1 − 0.2702) = 0.5773 / 0.7298 = 0.791
کاپای ۰٫۷۹ یعنی نقشه شما ۷۹ درصد از فاصله بین «طبقهبندی تصادفی» و «طبقهبندی کامل» را پیموده است. فرمول معادل که در کتابها میبینید K = (N·Σxii − Σ(xi+·x+i)) / (N² − Σ(xi+·x+i)) است: (400×339 − 43225) / (160000 − 43225) = 92375 / 116775 = 0.791.
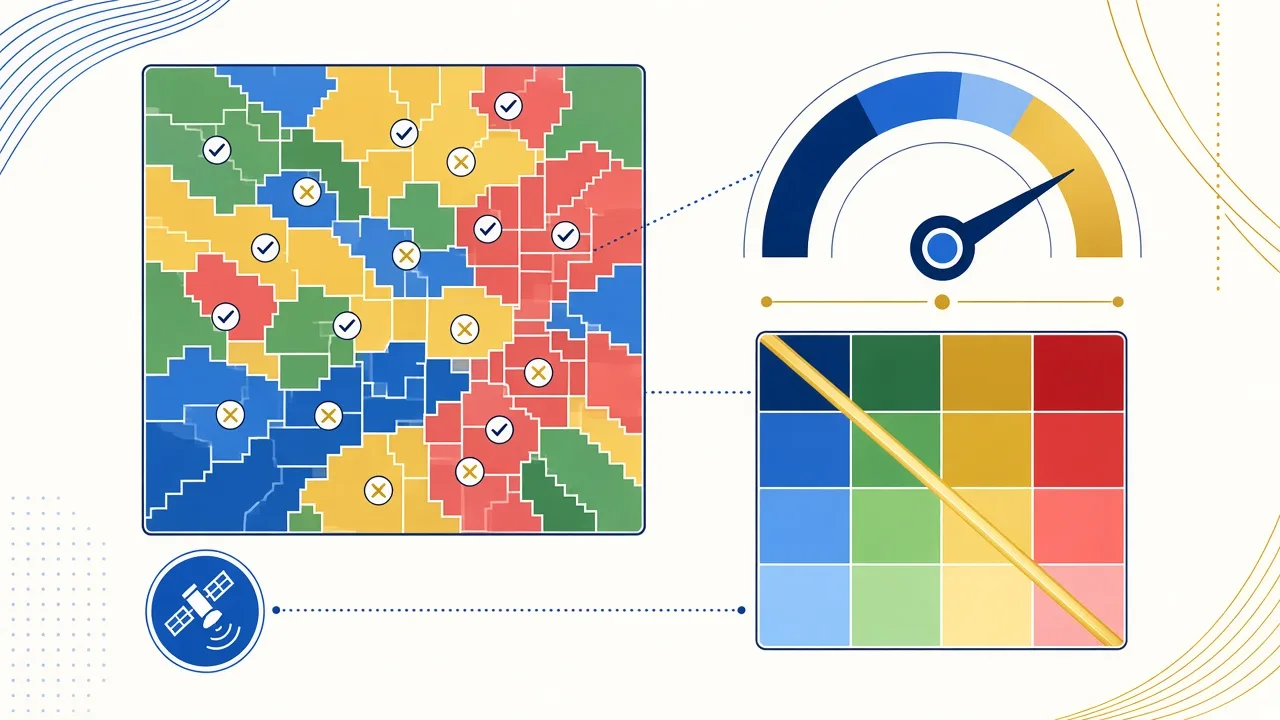
گام ۴: صحت کاربر و صحت تولیدکننده
| کلاس | صحت کاربر (UA) | خطای ارتکاب | صحت تولیدکننده (PA) | خطای حذف | کاپای شرطی |
|---|---|---|---|---|---|
| ساختهشده | ۸۵ ÷ ۱۰۰ = ۸۵٫۰٪ | ۱۵٫۰٪ | ۸۵ ÷ ۱۰۰ = ۸۵٫۰٪ | ۱۵٫۰٪ | ۰٫۸۰ |
| کشاورزی | ۱۱۲ ÷ ۱۳۰ = ۸۶٫۲٪ | ۱۳٫۸٪ | ۱۱۲ ÷ ۱۳۵ = ۸۳٫۰٪ | ۱۷٫۰٪ | ۰٫۷۹ |
| مرتع | ۹۲ ÷ ۱۱۵ = ۸۰٫۰٪ | ۲۰٫۰٪ | ۹۲ ÷ ۱۱۰ = ۸۳٫۶٪ | ۱۶٫۴٪ | ۰٫۷۲ |
| آب | ۵۰ ÷ ۵۵ = ۹۰٫۹٪ | ۹٫۱٪ | ۵۰ ÷ ۵۵ = ۹۰٫۹٪ | ۹٫۱٪ | ۰٫۹۰ |
- صحت کاربر (قطر ÷ جمع سطر): اگر کاربر نقشه به پیکسلی با برچسب «مرتع» برود، به احتمال ۸۰ درصد واقعاً مرتع میبیند. مکمل آن خطای ارتکاب (Commission) است: پیکسلهایی که اشتباهاً به این کلاس اضافه شدهاند.
- صحت تولیدکننده (قطر ÷ جمع ستون): از کل کشاورزی واقعی، ۸۳ درصد درست شناسایی شده است. مکمل آن خطای حذف (Omission) است: کشاورزیهایی که از نقشه جا افتادهاند.
- کاپای شرطی هر کلاس با فرمول
(N·xii − xi+·x+i) / (N·xi+ − xi+·x+i)محاسبه میشود؛ برای ساختهشده:(400×85 − 100×100) / (400×100 − 100×100) = 0.80.
گام ۵: تفسیر
بیشترین اشتباه بین کشاورزی و مرتع است (۱۵ نقطه کشاورزی واقعی به عنوان مرتع و ۱۰ نقطه مرتع به عنوان کشاورزی). این الگو در دشتهای ایران بسیار رایج است چون دیمزارها و مراتع در تصویر بهاره شبیهاند. راه حل، افزودن تصویر تابستانه یا شاخص NDVI چندزمانه است؛ جزئیات در تهیه نقشه کاربری اراضی با طبقهبندی نظارتشده و محاسبه شاخص NDVI. همچنین ۸ نقطه مرتع در کلاس ساختهشده افتادهاند که احتمالاً خاک لخت یا رخنمون سنگی است.
چرا کاپا گاهی از صحت کلی گویاتر است؟
یک مثال ساده: منطقهای دارید که ۹۰ درصد آن مرتع و ۱۰ درصد کشاورزی است. اگر نقشهای بسازید که همه پیکسلها را «مرتع» بنامد، صحت کلی ۹۰ درصد میشود، در حالی که هیچ پیکسل کشاورزی شناسایی نشده است. کاپای همین نقشه دقیقاً صفر است، چون Po = 0.9 و Pe = 0.9 × 1 + 0.1 × 0 = 0.9. این همان جایی است که کاپا یا دستکم صحت کلاسبهکلاس، فریب صحت کلی بالا را آشکار میکند. در منطقهای که یک کلاس غالب است (مثلاً مرتع در بیشتر حوضههای زاگرس یا اراضی بایر در فلات مرکزی)، هرگز فقط به صحت کلی بسنده نکنید.
تفسیر مقدار ضریب کاپا
| مقدار کاپا | تفسیر (Landis و Koch) | در عمل سنجش از دور |
|---|---|---|
| کمتر از ۰ | بدتر از تصادف | اشتباه در کد کلاسها یا جابهجایی سطر و ستون |
| ۰ تا ۰٫۴۰ | ضعیف تا کم | غیرقابل قبول |
| ۰٫۴۱ تا ۰٫۶۰ | متوسط | فقط برای کلاسهای دشوار یا داده کمتفکیک |
| ۰٫۶۱ تا ۰٫۸۰ | قابل توجه | قابل قبول در بیشتر پروژهها |
| ۰٫۸۱ تا ۱ | تقریباً کامل | خوب؛ اگر بالای ۰٫۹۷ است به استقلال نقاط کنترل شک کنید |
محاسبه ضریب کاپا در نرمافزارها
ArcGIS Pro
- ابزار Create Accuracy Assessment Points: ورودی نقشه طبقهبندیشده، تعداد نقاط (مثلاً ۴۰۰) و روش Stratified Random. خروجی نقاطی با فیلد Classified است.
- در جدول ویژگی، فیلد GrndTruth را برای هر نقطه با مشاهده تصویر مرجع پر کنید. اگر داده مرجع لایه برداری است، با Spatial Join مقدار را منتقل کنید.
- ابزار Compute Confusion Matrix را اجرا کنید؛ جدول خروجی شامل U_Accuracy، P_Accuracy و Kappa است.
در Classification Wizard هم مرحله Accuracy Assessment همین کار را خودکار انجام میدهد. برای تسلط بر این مراحل، دوره ArcGIS Pro پیشرفته را ببینید.
QGIS
در افزونه SCP بخش Postprocessing ← Accuracy را باز کنید، رستر طبقهبندیشده و لایه مرجع (برداری یا رستری) را بدهید و فیلد کلاس را مشخص کنید. خروجی متنی شامل ماتریس خطا، صحت کلی، کاپا و برآورد مساحت با خطای استاندارد است. در Processing Toolbox هم الگوریتم r.kappa از GRASS در دسترس است.
Google Earth Engine
var validated = testPoints.classify(classifier);
var cm = validated.errorMatrix('class', 'classification');
print('Confusion matrix', cm);
print('Overall accuracy', cm.accuracy());
print('Kappa', cm.kappa());
print('Producers accuracy', cm.producersAccuracy());
print('Users accuracy', cm.consumersAccuracy());
توجه کنید GEE در errorMatrix سطرها را مرجع و ستونها را طبقهبندی قرار میدهد (برعکس جدول بالا) و به همین دلیل اسم صحت کاربر را consumersAccuracy گذاشته است. مقدمات محیط را در آشنایی با گوگل ارث انجین ببینید.
Excel یا پایتون
اگر ماتریس را دارید، در Excel با SUMPRODUCT جمع حاصلضرب سطر و ستون را بگیرید یا در پایتون از sklearn.metrics.cohen_kappa_score استفاده کنید. برای کار با رستر در پایتون، کار با دادههای رستری در پایتون را ببینید.
نقد ضریب کاپا: چرا برخی مجلات دیگر آن را نمیخواهند
این بخشی است که تقریباً هیچ منبع فارسی به آن نپرداخته است. Pontius و Millones در مقاله مشهور ۲۰۱۱ با عنوان «Death to Kappa» نشان دادند که کاپا اطلاعات تازهای نسبت به صحت کلی نمیدهد و «توافق تصادفی» که کاپا کم میکند، در طبقهبندی تصاویر مفهوم معناداری ندارد، چون هیچکس نقشه را تصادفی نمیسازد. پیشنهاد آنها گزارش دو مؤلفه خطاست:
- عدم توافق کمی (Quantity Disagreement): اختلاف در مقدار هر کلاس بین نقشه و مرجع. در مثال ما:
½ × (|100−100| + |130−135| + |115−110| + |55−55|) / 400 = 0.0125، یعنی ۱٫۲۵ درصد. - عدم توافق مکانی (Allocation Disagreement): مقدار درست است ولی جای آن غلط:
کل خطا − خطای کمی = 0.1525 − 0.0125 = 0.14، یعنی ۱۴ درصد.
تفسیر: نقشه ما مساحت کلاسها را تقریباً درست برآورد کرده، اما جای آنها را در ۱۴ درصد موارد اشتباه گذاشته است. این اطلاعات بسیار کاربردیتر از عدد ۰٫۷۹ است. همچنین Olofsson و همکاران (۲۰۱۴) روش استاندارد برآورد مساحت تعدیلشده و بازه اطمینان آن را پیشنهاد کردهاند که برای گزارش مساحت کلاسها و تغییرات بهشدت توصیه میشود. مقالات اصلی: Pontius و Millones، ۲۰۱۱ و Olofsson و همکاران، ۲۰۱۴.
مثال برآورد مساحت تعدیلشده (روش Olofsson)
فرض کنید مساحت کلاسها در نقشه شما ساختهشده ۱۲۰۰، کشاورزی ۵۴۰۰، مرتع ۴۱۰۰ و آب ۳۰۰ هکتار (کل ۱۱۰۰۰ هکتار) است. وزن هر کلاس نسبت مساحت نقشهای آن است (۰٫۱۰۹، ۰٫۴۹۱، ۰٫۳۷۳، ۰٫۰۲۷). نسبت واقعی هر کلاس مرجع j از رابطه p̂j = Σ Wi × nij / ni+ برآورد میشود. نتیجه برای ماتریس مثال ما:
| کلاس | مساحت نقشه (هکتار) | مساحت تعدیلشده (هکتار) | بازه اطمینان ۹۵٪ |
|---|---|---|---|
| ساختهشده | ۱۲۰۰ | ۱۵۲۴ | ± ۲۷۶ |
| کشاورزی | ۵۴۰۰ | ۵۲۷۷ | ± ۴۱۴ |
| مرتع | ۴۱۰۰ | ۳۷۷۸ | ± ۳۹۵ |
| آب | ۳۰۰ | ۴۲۱ | ± ۱۴۶ |
نکته شگفتانگیز: با وجود صحت کاربر و تولیدکننده ۸۵ درصدی برای کلاس ساختهشده، مساحت واقعی آن حدود ۲۷ درصد بیشتر از عدد نقشه برآورد میشود، چون مرتع و کشاورزی که مساحت بسیار بیشتری دارند، تعدادی پیکسل ساختهشده را در خود پنهان کردهاند. اگر پایاننامه شما درباره رشد شهری است، گزارش مساحت خام نقشه میتواند نتیجهگیری را منحرف کند. افزونه SCP در QGIS این برآورد را خودکار ارائه میدهد.
کاپای وزنی و سایر شاخصها
اگر کلاسهای شما ترتیبیاند (مثلاً کلاسهای تراکم پوشش یا شدت فرسایش)، اشتباه «خیلی کم» با «کم» به اندازه اشتباه «خیلی کم» با «خیلی زیاد» بد نیست. در این حالت کاپای وزنی (Weighted Kappa) با جریمه بیشتر برای اختلافهای دور مناسبتر است. برای نقشههای پهنهبندی مثل پهنهبندی سیلاب که با نقاط وقوع اعتبارسنجی میشوند، معمولاً منحنی ROC و سطح زیر منحنی (AUC) به جای کاپا گزارش میشود.
ارزیابی دقت در آشکارسازی تغییرات
در مطالعات تغییر، دقت هر نقشه جداگانه کافی نیست. اگر دو نقشه هر کدام ۹۰ درصد صحت داشته باشند، دقت نقشه تغییر در بدترین حالت میتواند تا حدود ۸۱ درصد (۰٫۹ × ۰٫۹) پایین بیاید و کلاسهای «تغییر» که مساحت کمی دارند، بسیار نامطمئنترند. بهتر است علاوه بر دقت هر نقشه، نقاط کنترل را مستقیماً روی کلاسهای تغییر (مثلاً «کشاورزی به ساختهشده») بگیرید. روش ساخت و تفسیر ماتریس انتقال را در آشکارسازی تغییرات کاربری اراضی ببینید.
خطاهای رایج در ارزیابی دقت و راه حل
| خطا | پیامد | راه حل |
|---|---|---|
| استفاده از نمونههای آموزش برای ارزیابی | کاپای کاذب ۰٫۹۵ به بالا | نقاط مستقل یا پلیگونهای جدا |
| نمونهگیری کاملاً تصادفی ساده | کلاس کوچک (مثلاً آب) فقط ۳ نقطه میگیرد | تصادفی طبقهبندیشده، حداقل ۵۰ نقطه هر کلاس |
| تصویر مرجع با تاریخ متفاوت | تغییر واقعی به عنوان خطا ثبت میشود | تصویر مرجع همزمان یا نزدیک |
| جابهجایی سطر و ستون | جابهجایی UA و PA در گزارش | بررسی تعریف ماتریس هر نرمافزار |
| نقاط روی مرز کلاسها | خطای ناشی از پیکسل مخلوط و جابهجایی | حذف نقاط در فاصله یک پیکسل از مرز یا گزارش جداگانه |
| گزارش فقط کاپا | پنهان ماندن کلاس ضعیف | گزارش ماتریس کامل و UA/PA |
قالب گزارش دقت در فصل نتایج
- روش نمونهگیری، تعداد نقاط هر کلاس و منبع داده مرجع.
- جدول ماتریس خطای کامل با جمع سطر و ستون.
- جدول UA، PA، خطای حذف و ارتکاب هر کلاس.
- صحت کلی و ضریب کاپا (و در صورت امکان خطای کمی و مکانی).
- تحلیل اشتباههای اصلی و دلیل طیفی یا زمانی آنها.
- در صورت گزارش مساحت، برآورد مساحت تعدیلشده و بازه اطمینان ۹۵ درصد.
اگر برای نگارش فصل روش یا تحلیل دقت پایاننامه نیاز به مشاوره دارید، از طریق صفحه تماس گیسلند درخواست بدهید. برای مبانی آماری بیشتر، آمار فضایی چیست؟ را بخوانید.
جمعبندی و نکات کلیدی
- ضریب کاپا در سنجش از دور = (Po − Pe) / (1 − Pe)؛ توافق فراتر از شانس.
- در مثال ما صحت کلی ۸۴٫۷۵٪ و کاپا ۰٫۷۹ شد؛ ضعف اصلی اشتباه کشاورزی و مرتع بود.
- صحت کاربر از دید استفادهکننده نقشه و صحت تولیدکننده از دید تهیهکننده است.
- نقاط کنترل باید مستقل، کافی و تصادفی طبقهبندیشده باشند.
- کاپا را همراه ماتریس کامل، UA/PA و ترجیحاً خطای کمی و مکانی گزارش کنید.
پرسشهای متداول درباره ضریب کاپا در سنجش از دور
ضریب کاپا چند باشد قابل قبول است؟
تفاوت صحت کلی و ضریب کاپا چیست؟
صحت کاربر و صحت تولیدکننده چه فرقی دارند؟
برای محاسبه ضریب کاپا چند نقطه کنترل لازم است؟
چرا کاپای من خیلی بالا (مثلاً ۰٫۹۹) است؟
مطالب مرتبط
ارزیابی دقت را مثل یک داور حرفهای انجام دهید
در دوره RGIS Pro (مسیر ArcGIS Pro گیسلند) طبقهبندی، نمونهگیری کنترل، ماتریس خطا و گزارش دقت را روی تصاویر واقعی تمرین میکنید تا فصل روش پایاننامه و گزارش پروژهتان قابل دفاع باشد.
- ۴۰ ساعت آموزش مهارتمحور و پروژهمحور ArcGIS Pro، از مقدماتی تا پیشرفته
- یک سال پشتیبانی و رفع اشکال رایگان پس از پایان دوره
- تمرین روی دادههای واقعی ایران؛ مناسب پایاننامه، پروژه سازمانی و بازار کار
- دسترسی مستقیم به مدرس: دکتر سعید جویزاده
مشاهده دوره RGIS Pro (ArcGIS Pro)سطح پیشرفتهتماس: ۰۹۱۲ ۰۴۳ ۸۸۷۴واتساپ: ۰۹۳۸ ۲۲۵ ۲۷۷۴
فرم ثبتنام و مشاوره رایگان دوره RGIS Pro
نام و شمارهتان را بگذارید تا کارشناسان GISLAND برای مشاوره رایگان، تعیین سطح و زمانبندی کلاس با شما تماس بگیرند. اطلاعات شما فقط برای همین تماس استفاده میشود.
ترجیح میدهید مستقیم صحبت کنید؟ تماس ۰۹۱۲۰۴۳۸۸۷۴ یا ۰۹۳۸۲۲۵۲۷۷۴ · واتساپ ۰۹۳۸۲۲۵۲۷۷۴


بدون دیدگاه