


نقشهی هزار نقطهی تصادف رانندگی یا پانصد شعبهی یک فروشگاه زنجیرهای را تصور کنید. چشم ما میگوید «بیشتر در شمال شهر» یا «در امتداد بزرگراه»، اما این توصیفها نه دقیقاند و نه قابل مقایسه. آمار فضایی در ArcGIS Pro این برداشتهای ذهنی را به عدد و شکل تبدیل میکند: مرکز ثقل داده کجاست، کدام عارضه در مرکز قرار دارد، داده چقدر پراکنده است و در چه جهتی کشیده شده است. در این آموزش ArcGIS Pro ابزارهای اندازهگیری توزیع جغرافیایی یعنی Mean Center، Median Center، Central Feature، Standard Distance و Directional Distribution را قدمبهقدم یاد میگیریم و با هم مقایسه میکنیم.
📚 مسیر یادگیری: این مطلب فصل ۱۳ از مجموعهی ۱۴ فصلی «کتابخوانی عملی ArcGIS Pro» در گیسلند است؛ فهرست کامل فصلها را در صفحهی دوره جامع آموزش آرکجیایاس پرو ببینید. این مجموعه بخشی از آموزش آرک جی آی اس پرو از صفر تا پیشرفته است. فایلهای تمرینی را از داده های آرک جی آی اس پرو بردارید و تمرینهای بیشتر را در تمرین های آرک جی آی اس پرو ببینید.
این فصل ادامهی مستقیم فصل دوازدهم: تحلیل مجاورت در ArcGIS Pro است. در آنجا پرسیدیم «چه چیزی نزدیک است؟» و اینجا میپرسیم «الگوی کلی کجاست و چه شکلی دارد؟». همهی ابزارهای این فصل در جعبهابزار Spatial Statistics و در لایسنس Basic در دسترساند، اما برای نتیجهی درست به دادهی تصویرشده (Projected) نیاز دارند.
🧭 فهرست مطالب این آموزش
- 🧭 آمار فضایی چیست و چه پرسشهایی را پاسخ میدهد؟
- 🧮 شهود ریاضی: این اعداد از کجا میآیند؟
- 🎯 آمادهسازی داده و انتخاب زیرمجموعه
- ⊕ مرکز میانگین با Mean Center
- ⊙ مرکز میانه با Median Center
- 📌 یافتن عارضهی مرکزی با Central Feature
- ⭕ سنجش پراکندگی با Standard Distance
- 🥚 جهت و کشیدگی با Directional Distribution
- 🧠 دامهای تفسیری که باید بشناسید
- 💼 سناریوهای کاربردی آمار فضایی در ArcGIS Pro
- 🔥 گام بعدی: از توزیع به الگو و لکههای داغ
- 🎨 نمایش و گزارش نتایج
- 🐍 اجرای سریع با Python
- 🧪 تمرین عملی: الگوی مکانی تصادفهای شهری
- 🏙️ سناریوی واقعی: ردیابی جابهجایی مرکز تصادفات شهری در سه سال
- 🐞 خطاهای رایج و راهحل
- ❓ پرسشهای متداول
- 🏁 جمعبندی
🧭 آمار فضایی چیست و چه پرسشهایی را پاسخ میدهد؟
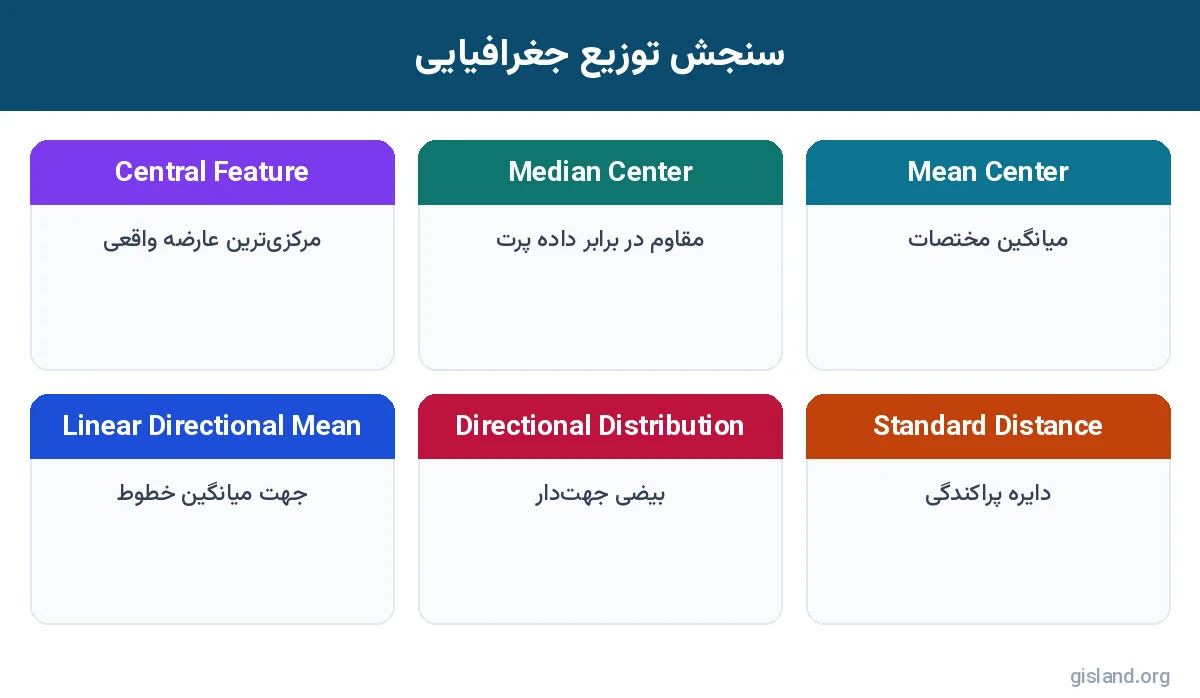
آمار کلاسیک برای یک ستون عدد، میانگین و انحراف معیار حساب میکند. آمار فضایی همین مفاهیم را به مکان تعمیم میدهد: میانگین مختصات، پراکندگی مختصات و جهت پراکندگی. جعبهابزار Spatial Statistics در ArcGIS Pro چند مجموعه ابزار دارد:
این آموزش روی مجموعهی اول تمرکز دارد که پایهی بقیه است. تحلیل لکههای داغ (Hot Spot) موضوع یک آموزش جداگانه در مجموعهی گیسلند است.
💡 چرا این ابزارها مهماند؟
- مقایسه در زمان: مرکز میانگین جرائم امسال نسبت به پارسال چند متر و به کدام سمت جابهجا شده است؟
- مقایسهی گروهها: آیا تصادفهای شبانه پراکندهتر از تصادفهای روزانهاند؟
- تصمیم مکانی: انبار مرکزی را کجا بسازیم که به همهی شعبهها نزدیک باشد؟
- جهت پدیده: آیا گسترش شهر یا پخش یک بیماری در جهت خاصی کشیده شده است؟
📐 پیشنیاز: دادهی تصویرشده
مستندات Esri برای همهی این ابزارها تأکید میکند که محاسبهی دقیق فاصله به دادهی تصویرشده نیاز دارد. اگر داده در WGS 1984 جغرافیایی است، ابتدا با Project آن را به UTM منطقهی خود ببرید یا محیط Output Coordinate System را تنظیم کنید. روش کار در فصل هفتم: سیستم مختصات در ArcGIS Pro آمده است.
⚠️ هشدار
نتیجهی Standard Distance و Directional Distribution روی دادهی جغرافیایی (درجهای) یا Web Mercator گمراهکننده است؛ دایره و بیضی ممکن است کشیده یا با ابعاد نادرست ساخته شوند.
✅ نکات کلیدی این بخش
- آمار فضایی میانگین و پراکندگی را به مکان تعمیم میدهد
- چهار مجموعه ابزار: توزیع، الگو، خوشه، مدل
- این آموزش: سنجش توزیع جغرافیایی
- داده را پیش از تحلیل Project کنید
🧮 شهود ریاضی: این اعداد از کجا میآیند؟
لازم نیست فرمولها را حفظ کنید، اما دانستن منطق آنها تفسیر را بسیار دقیقتر میکند.
یک مثال ذهنی: پنج نقطه در یک خط افقی با X برابر ۰، ۱، ۲، ۳ و ۱۰۰ کیلومتر. Mean Center در X برابر ۲۱ کیلومتر میافتد؛ جایی که هیچ نقطهای نزدیکش نیست. Median Center نزدیک X برابر ۲ قرار میگیرد و Central Feature همان نقطهی X برابر ۲ است. همین مثال ساده نشان میدهد چرا انتخاب شاخص به هدف و شکل داده بستگی دارد.
⚖️ نقش وزن
وقتی Weight Field تعیین میکنید، هر عارضه به اندازهی وزنش «تکرار» فرض میشود. مثلاً اگر فروشگاهی ۱۰ برابر فروشگاه دیگر فروش دارد، اثرش بر مرکز میانگین وزنی مثل ده فروشگاه هممکان است. چند نکتهی عملی:
- وزن منفی یا صفر را بررسی کنید؛ وزن صفر عملاً عارضه را از محاسبه حذف میکند.
- اگر وزنها دامنهی بسیار بزرگی دارند (مثلاً جمعیت روستا از ۵۰ تا ۵۰۰٬۰۰۰ برای شهر)، یک عارضهی بزرگ میتواند کل نتیجه را تعیین کند. گاهی تحلیل بدون وزن و با وزن را کنار هم گزارش کنید.
- برای چندضلعیها، اگر میخواهید چندضلعیهای بزرگتر اثر بیشتری داشته باشند، فیلد مساحت را وزن قرار دهید.
✅ نکات کلیدی این بخش
- Mean مثل میانگین، Median مثل میانه
- Standard Distance مثل انحراف معیار
- وزن یعنی تکرار مجازی عارضه
- وزنهای با دامنهی زیاد را با احتیاط تفسیر کنید
🎯 آمادهسازی داده و انتخاب زیرمجموعه
پیش از اجرای ابزارها، باید روشن کنید کدام عوارض در تحلیل شرکت کنند. همهی ابزارهای Spatial Statistics به انتخاب و Definition Query احترام میگذارند؛ یعنی اگر عوارضی انتخاب شده باشد، فقط همانها تحلیل میشوند.
- ۱داده را بررسی کنید: نقاط تکراری، مختصات صفر یا خارج از محدوده و هندسهی خالی را با Check Geometry و Select By Attributes پیدا و اصلاح کنید.
- ۲اگر تحلیل به یک منطقه محدود است، با Select By Location و رابطهی Within a distance یا Intersect عوارض آن منطقه را انتخاب کنید. جزئیات انتخاب بر اساس فاصله در فصل دوازدهم آمده است.
- ۳اگر فقط یک نوع رویداد مهم است (مثلاً تصادفهای منجر به جرح)، با Definition Query لایه را فیلتر کنید.
- ۴فیلد وزن را آماده کنید: اگر هر نقطه اهمیت متفاوتی دارد (مثلاً تعداد مصدوم یا میزان فروش)، مطمئن شوید این فیلد عددی و بدون Null است.
- ۵فیلد گروه (Case Field) را آماده کنید: اگر میخواهید برای هر سال یا هر نوع جداگانه نتیجه بگیرید، یک فیلد متنی، عددی یا تاریخ برای گروهبندی داشته باشید.
💡 نکته
برای تحلیل جداگانهی چند گروه، به جای چند بار انتخاب و اجرا، از پارامتر Case Field استفاده کنید. ابزار برای هر مقدار یک خروجی جداگانه در همان لایه میسازد و مقایسه بسیار سادهتر میشود. رکوردهایی که در Case Field مقدار Null دارند، از تحلیل کنار گذاشته میشوند.
📌 یادداشت
برای عوارض خطی و چندضلعی، این ابزارها از مرکز هندسی (Centroid) هر عارضه استفاده میکنند. یعنی یک چندضلعی بزرگ و یک چندضلعی کوچک هر کدام یک نقطه به حساب میآیند، مگر اینکه وزن بدهید.
✅ نکات کلیدی این بخش
- انتخاب و Definition Query تحلیل را محدود میکنند
- داده را پیش از تحلیل پاکسازی کنید
- فیلد وزن عددی و بدون Null
- Case Field برای گروهها
⊕ مرکز میانگین با Mean Center
Mean Center سادهترین شاخص تمرکز است: نقطهای که X آن میانگین X همهی عوارض و Y آن میانگین Y همهی عوارض است. اگر داده Z داشته باشد، میانگین Z هم محاسبه میشود. این نقطه همان «مرکز ثقل» داده است.
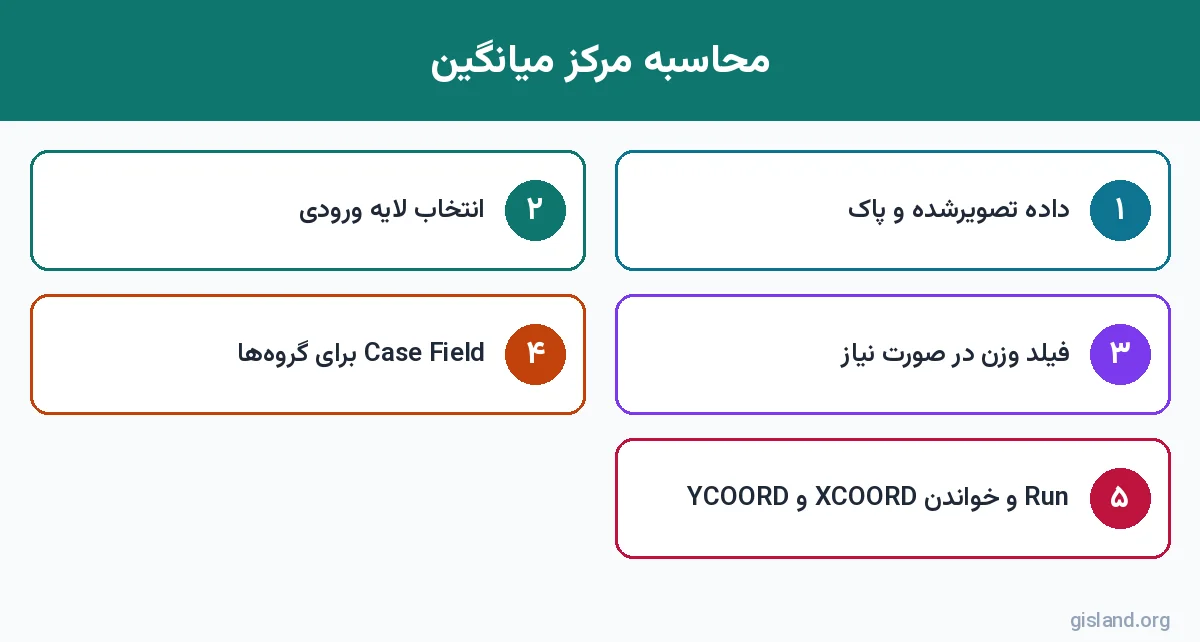
🛠️ مراحل
- ۱در زبانهی Analysis روی Tools کلیک و
Mean Centerرا جستوجو کنید. ابزار در Spatial Statistics > Measuring Geographic Distributions قرار دارد. - ۲Input Feature Class: لایهی نقاط، مثلاً Accidents.
- ۳Output Feature Class: نام خروجی، مثلاً
Accidents_MeanCenter. - ۴Weight Field (اختیاری): فیلد وزن؛ مثلاً تعداد مصدومان. نقاط با وزن بیشتر مرکز را به سمت خود میکشند.
- ۵Case Field (اختیاری): مثلاً
Yearتا برای هر سال یک مرکز ساخته شود. - ۶Dimension Field (اختیاری): یک فیلد عددی که میانگین آن هم در خروجی محاسبه شود.
- ۷Run را بزنید. خروجی یک لایهی نقطهای است با فیلدهای XCOORD و YCOORD (و ZCOORD در دادهی سهبعدی).
📊 تفسیر نتیجه
مرکز میانگین لزوماً روی یک عارضهی واقعی نیست و حتی ممکن است در جایی بیمعنا مثل وسط یک دریاچه بیفتد؛ مثلاً اگر شعبههای یک بانک دور تا دور یک دریاچه باشند. این نقطه بیشتر برای مقایسه ارزشمند است تا برای مکانیابی مستقیم.
قدرت واقعی Mean Center با Case Field آشکار میشود: اگر برای پنج سال پنج مرکز بسازید و آنها را به ترتیب سال با یک خط به هم وصل کنید (ابزار Points To Line با فیلد مرتبسازی Year)، مسیر جابهجایی مرکز جرائم یا تصادفها در طول زمان دیده میشود.
⚠️ هشدار
Mean Center به دادههای پرت حساس است. یک نقطهی اشتباه با مختصات صفر (مثلاً در خلیج گینه) کل مرکز را بهشدت جابهجا میکند. پیش از تحلیل، دادههای پرت را بررسی کنید یا از Median Center استفاده کنید.
✅ نکات کلیدی این بخش
- Mean Center میانگین مختصات است
- وزن، مرکز را به سمت عوارض مهمتر میکشد
- Case Field برای مقایسهی زمانی یا گروهی
- به دادهی پرت حساس است
⊙ مرکز میانه با Median Center
Median Center نقطهای است که مجموع فاصلهی اقلیدسی آن تا همهی عوارض کمینه است. این نقطه با یک الگوریتم تکراری پیدا میشود و برخلاف Mean Center در برابر دادههای پرت مقاومتر است.
- ۱ابزار Median Center را باز کنید.
- ۲Input Feature Class و Output را تعیین کنید.
- ۳در صورت نیاز Weight Field، Case Field و Attribute Field را تنظیم کنید. Attribute Field میانهی مقادیر یک فیلد عددی را هم محاسبه میکند.
- ۴Run را بزنید.
💡 نکته
هر دو ابزار را روی یک داده اجرا کنید و نتایج را روی نقشه کنار هم ببینید. اگر Mean Center و Median Center فاصلهی زیادی از هم دارند، یعنی داده نامتقارن است یا دادهی پرت دارد؛ این خودش یک یافتهی مهم است.
📌 یادداشت
از نظر مفهومی، Median Center پاسخ پرسش «یک تأسیسات را کجا بگذاریم که مجموع فاصلهی همهی متقاضیان تا آن کمینه شود؟» است، با این فرض که فاصلهی خط هوایی ملاک باشد. برای فاصلهی جادهای، از تحلیل Location-Allocation در Network Analyst استفاده کنید.
✅ نکات کلیدی این بخش
- Median Center مجموع فاصله را کمینه میکند
- در برابر دادهی پرت مقاومتر است
- اختلاف زیاد با Mean Center یعنی عدم تقارن
📌 یافتن عارضهی مرکزی با Central Feature
گاهی به یک نقطهی فرضی نیاز ندارید، بلکه باید یکی از عوارض موجود را انتخاب کنید: کدام شعبهی موجود برای دفتر منطقهای مناسبتر است؟ کدام مدرسه برای برگزاری آزمون مشترک در مرکز قرار دارد؟ Central Feature عارضهای را پیدا میکند که کمترین مجموع فاصله تا همهی عوارض دیگر را دارد.
🛠️ مراحل
- ۱ابزار Central Feature را باز کنید.
- ۲Input Feature Class: مثلاً Schools.
- ۳Output Feature Class: مثلاً
Schools_Central. - ۴Distance Method: Euclidean (خط مستقیم) یا Manhattan (مجموع فاصلهی افقی و عمودی، مناسب شهرهای با خیابانهای شطرنجی).
- ۵Weight Field (اختیاری): مثلاً تعداد دانشآموزان هر مدرسه؛ عوارض پرجمعیتتر اثر بیشتری دارند.
- ۶Self Potential Weight Field (اختیاری): وزن «فاصله تا خود»؛ برای مواقعی که خود عارضه هم تقاضا دارد.
- ۷Case Field (اختیاری): مثلاً
Districtتا برای هر منطقه یک مدرسهی مرکزی انتخاب شود. - ۸Run را بزنید. خروجی کپی عارضه(های) مرکزی با همهی فیلدهایش است.
💡 نکته
Central Feature همیشه روی یک عارضهی واقعی است، پس برای تصمیمگیری اجرایی قابل استفادهتر است. اگر چند عارضه کمترین مجموع فاصلهی برابر داشته باشند، همهی آنها در خروجی کپی میشوند.
✅ نکات کلیدی این بخش
- Central Feature یکی از عوارض موجود را برمیگزیند
- Euclidean یا Manhattan بر اساس ساختار شهر
- وزن برای اهمیت متفاوت عوارض
- برای تصمیم اجرایی مناسبتر است
⭕ سنجش پراکندگی با Standard Distance
دو مجموعه داده ممکن است مرکز میانگین یکسانی داشته باشند اما یکی متمرکز و دیگری پراکنده باشد. Standard Distance میزان پراکندگی را با یک عدد (و یک دایره) نشان میدهد؛ همان کاری که انحراف معیار برای یک ستون عدد انجام میدهد. خروجی دایرهای است به مرکز Mean Center و شعاع فاصلهی استاندارد.
🛠️ مراحل
- ۱ابزار Standard Distance را باز کنید.
- ۲Input Feature Class و Output Standard Distance Feature Class را تعیین کنید.
- ۳Circle Size را انتخاب کنید: 1 standard deviation، 2 یا 3.
- ۴در صورت نیاز Weight Field و Case Field را تنظیم کنید.
- ۵Run را بزنید. فیلد اصلی خروجی، فاصلهی استاندارد به واحد سیستم مختصات است.
این درصدها فقط برای توزیع تقریباً نرمال برقرارند؛ دادههای واقعی شهری اغلب خوشهایاند و درصد واقعی متفاوت است. برای گزارش، به جای ادعای درصد، از Standard Distance برای مقایسهی پراکندگی دو گروه یا دو دوره استفاده کنید.
💡 نکته
برای مقایسهی پراکندگی تصادفهای روز و شب، فیلد DayNight را Case Field بگذارید. اگر دایرهی شب بزرگتر است، تصادفهای شبانه در سطح وسیعتری از شهر پخش شدهاند؛ یافتهای که میتواند برنامهی گشت پلیس را تغییر دهد.
✅ نکات کلیدی این بخش
- Standard Distance انحراف معیار مکانی است
- دایرهای به مرکز Mean Center
- درصدها فقط برای توزیع نرمال
- بهترین کاربرد: مقایسه
🥚 جهت و کشیدگی با Directional Distribution
دایره فرض میکند داده در همهی جهات یکسان پخش شده است، اما بیشتر پدیدهها جهتدارند: سکونتگاهها در امتداد دره، تصادفها در امتداد بزرگراه، آلودگی در جهت باد. Directional Distribution که با نام بیضی انحراف معیار (Standard Deviational Ellipse) هم شناخته میشود، پراکندگی را در دو محور جداگانه میسنجد و یک بیضی جهتدار میسازد.
🛠️ مراحل
- ۱ابزار Directional Distribution (Standard Deviational Ellipse) را باز کنید.
- ۲Input Feature Class و Output Ellipse Feature Class را تعیین کنید.
- ۳Ellipse Size: 1، 2 یا 3 انحراف معیار.
- ۴Weight Field و Case Field را در صورت نیاز تنظیم کنید.
- ۵Run را بزنید.
- ۶خروجی را با رنگ توخالی و خط پررنگ نمایش دهید تا دادهی زیرین دیده شود.
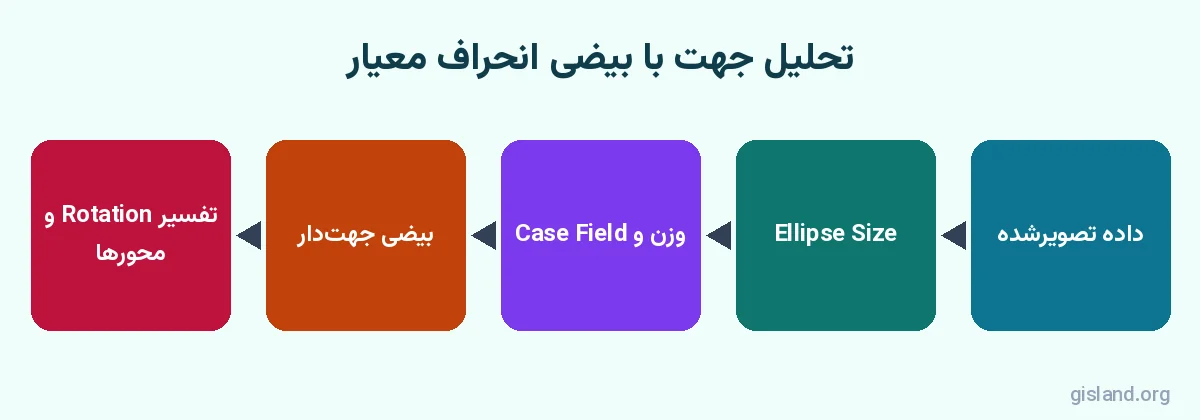
📋 فیلدهای خروجی و تفسیر
نسبت محور بلند به کوتاه شدت جهتداری را نشان میدهد: نسبت نزدیک به ۱ یعنی بیضی تقریباً دایره و داده بدون جهت خاص؛ نسبت ۳ یا بیشتر یعنی داده بهشدت در یک جهت کشیده شده است. این نسبت را میتوانید با Calculate Field و تقسیم بزرگتر بر کوچکتر از دو فیلد XStdDist و YStdDist محاسبه کنید.
💡 نکته
برای عوارض خطی (مثل مسیر طوفانها یا گسلها)، ابزار Linear Directional Mean جهت میانگین خطوط را محاسبه میکند و تکمیلکنندهی Directional Distribution است.
📌 یادداشت
اگر داده Z داشته باشد، Directional Distribution یک بیضیگون سهبعدی (Multipatch) میسازد که باید در Scene نمایش داده شود. برای کار با صحنهی سهبعدی، فصل چهاردهم: تحلیل سه بعدی در ArcGIS Pro را ببینید.
✅ نکات کلیدی این بخش
- بیضی پراکندگی را در دو محور میسنجد
- Rotation جهت کشیدگی را میدهد
- نسبت محورها شدت جهتداری
- Linear Directional Mean برای خطوط
🧠 دامهای تفسیری که باید بشناسید
خطای ابزار معمولاً پیام خطا میدهد؛ اما خطای تفسیر بیصدا است و میتواند به تصمیم اشتباه برسد. چهار دام رایج:
- ۱اثر مرز محدودهی مطالعه: اگر فقط دادهی داخل مرز شهرداری را تحلیل کنید، مرکز و بیضی به داخل مرز «کشیده» میشوند، حتی اگر پدیده بیرون از مرز ادامه داشته باشد. محدودهی مطالعه را بر اساس پدیده انتخاب کنید، نه بر اساس مرز اداری.
- ۲سوگیری دادهبرداری: اگر تصادفها فقط در خیابانهای اصلی ثبت شدهاند (چون گشت پلیس فقط آنجاست)، بیضی جهت خیابانهای اصلی را نشان میدهد، نه الگوی واقعی تصادف را. همیشه بپرسید داده چطور جمع شده است.
- ۳مسئلهی واحد مساحتی قابل تغییر (MAUP): اگر به جای نقاط از Centroid چندضلعیها (مثلاً بلوکهای آماری) استفاده کنید، تغییر اندازه یا مرز چندضلعیها نتیجه را تغییر میدهد. نتیجه را با دو سطح تجمیع آزمون کنید.
- ۴یک عدد برای کل داده: یک بیضی برای کل استان ممکن است الگوهای متفاوت شهرهای مختلف را پنهان کند. با Case Field بر اساس شهر یا منطقه، الگوهای محلی را جداگانه ببینید.
قاعدهی کلی: نتیجهی آمار فضایی را همیشه کنار نقشهی دادهی خام نشان دهید؛ اگر بیضی با آنچه چشم میبیند بهکلی متفاوت است، احتمالاً یکی از این دامها در کار است.
✅ نکات کلیدی این بخش
- مرز مطالعه را بر اساس پدیده انتخاب کنید
- نحوهی جمعآوری داده را بپرسید
- نتیجه را با دو سطح تجمیع آزمون کنید
- الگوهای محلی را با Case Field ببینید
💼 سناریوهای کاربردی آمار فضایی در ArcGIS Pro
ابزارهای سنجش توزیع وقتی کنار هم به کار روند، داستان کاملی از داده تعریف میکنند. سه سناریوی زیر نشان میدهد چطور.
🚗 سناریو ۱: جابهجایی کانون تصادفها در پنج سال
پلیس راهور میخواهد بداند آیا با ساخت کمربندی جدید، کانون تصادفها جابهجا شده است یا نه.
- ۱لایهی تصادفها را با فیلد
Yearآماده و به UTM تصویر کنید. - ۲Mean Center را با Case Field = Year و Weight Field = تعداد مصدومان اجرا کنید.
- ۳با Points To Line و Sort Field = Year، مراکز را به یک خط مسیر تبدیل کنید و با نماد فلشدار نمایش دهید.
- ۴Directional Distribution را با Case Field = Year و اندازهی ۱ انحراف معیار اجرا کنید.
- ۵بیضیهای سالهای قبل و بعد از افتتاح کمربندی را با دو رنگ متفاوت روی نقشه نمایش دهید.
اگر پس از افتتاح، بیضی در امتداد کمربندی چرخیده و مرکز به سمت آن جابهجا شده، شاهد کمّی برای انتقال بار ترافیک و ریسک تصادف به مسیر جدید دارید. این تحلیل در کمتر از یک ساعت، یک ادعای کیفی را به یک یافتهی قابل ارائه تبدیل میکند.
🏪 سناریو ۲: انتخاب دفتر منطقهای از میان شعبههای موجود
یک شرکت پخش با ۸۰ شعبه در سه استان میخواهد در هر استان یکی از شعبههای فعلی را دفتر منطقهای کند.
- ۱Central Feature را با Case Field = Province و Weight Field = حجم فروش ماهانه اجرا کنید.
- ۲Distance Method را برای فواصل بینشهری Euclidean بگذارید.
- ۳برای مقایسه، Median Center را هم با همان وزن و Case Field اجرا کنید.
- ۴فاصلهی شعبهی انتخابشده تا Median Center هر استان را با Near بسنجید؛ اگر فاصله زیاد است، شاید ساخت دفتر جدید در نزدیکی Median Center گزینهی بهتری باشد.
🌳 سناریو ۳: گسترش یک آفت درختی
کارشناسان منابع طبیعی محل درختان آلوده را در سه فصل ثبت کردهاند و میخواهند جهت گسترش آفت را بدانند.
- ۱Standard Distance را با Case Field = Season اجرا کنید تا رشد دایرهی پراکندگی در هر فصل دیده شود.
- ۲Directional Distribution را با همان Case Field اجرا کنید.
- ۳Rotation بیضیها را در جدول مقایسه کنید؛ چرخش ثابت یعنی گسترش در یک جهت پایدار، مثلاً همجهت با باد غالب یا یک دره.
- ۴نتیجه را با لایهی جهت باد یا شیب منطقه روی هم بگذارید تا فرضیهی عامل گسترش بررسی شود.
✅ نکات کلیدی این بخش
- Case Field برای مقایسهی زمانی
- Points To Line برای مسیر جابهجایی مرکز
- Central Feature و Median Center برای مکانیابی
- Rotation برای جهت گسترش
🔥 گام بعدی: از توزیع به الگو و لکههای داغ
ابزارهای این فصل توصیفیاند: میگویند مرکز کجاست و پراکندگی چقدر است، اما نمیگویند آیا این الگو از نظر آماری معنادار است. برای آن به ابزارهای استنباطی نیاز دارید:
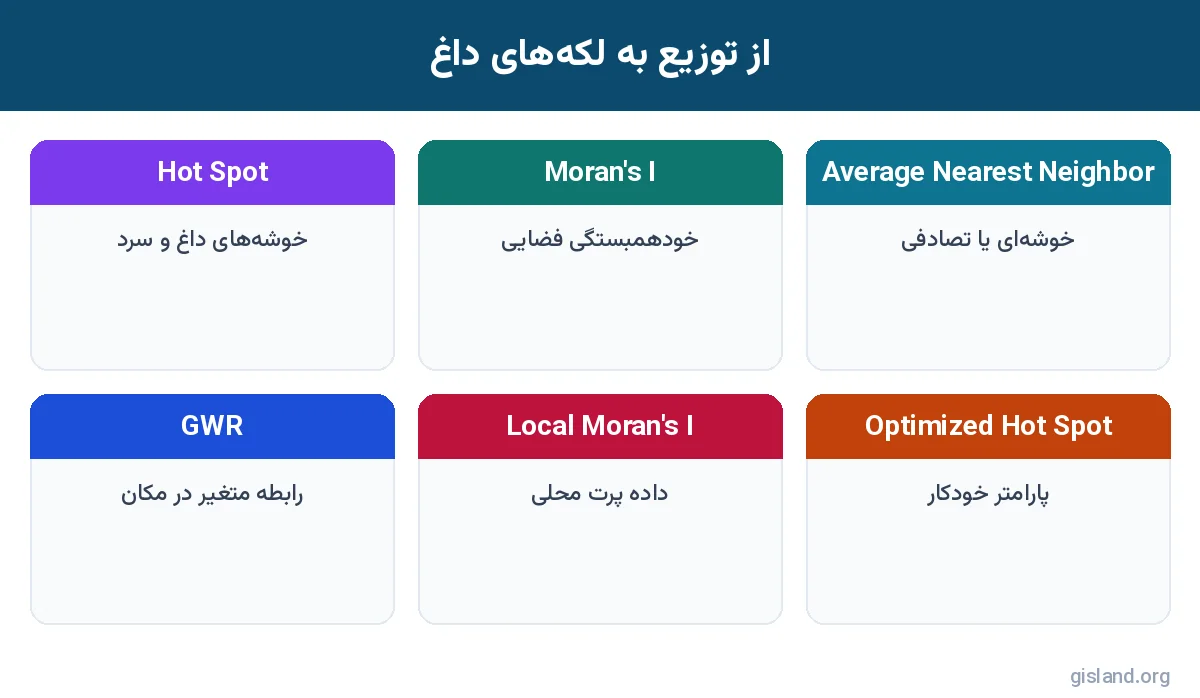
یک گردش کار حرفهای معمولاً با Mean Center و Directional Distribution برای شناخت اولیه شروع میشود، با Average Nearest Neighbor معناداری خوشهبندی را آزمون میکند و با Hot Spot Analysis محل دقیق خوشهها را نشان میدهد. تحلیل لکههای داغ موضوع یک آموزش اختصاصی در مجموعهی گیسلند است.
⚠️ هشدار
ابزارهای استنباطی به اندازهی نمونه حساساند. Esri برای Hot Spot Analysis حداقل حدود ۳۰ عارضه را توصیه میکند؛ با دادهی خیلی کم، نتیجه قابل اعتماد نیست.
✅ نکات کلیدی این بخش
- ابزارهای این فصل توصیفیاند
- Average Nearest Neighbor و Moran’s I برای معناداری
- Hot Spot برای محل خوشهها
- دادهی کافی شرط اعتبار است
🎨 نمایش و گزارش نتایج
- ترتیب لایهها: دادهی خام زیر، بیضیها و دایرهها در وسط (توخالی با خط پررنگ) و نقاط مرکز در بالا.
- رنگ برای گروهها: وقتی Case Field دارید، از Unique Values با رنگهای متمایز برای هر گروه استفاده کنید.
- برچسب مرکز: مرکز هر سال را با برچسب سال نمایش دهید تا مسیر جابهجایی خوانا باشد.
- جدول خلاصه: در Layout یک جدول کوچک از Standard Distance و نسبت محورهای هر گروه بگذارید.
- چارت: با Bar Chart مقدار Standard Distance گروهها را مقایسه کنید.
💡 نکته
در گزارش متنی، اعداد را با واحد و تفسیر بنویسید؛ مثلاً «فاصلهی استاندارد تصادفهای شبانه ۳٫۲ کیلومتر و تصادفهای روزانه ۲٫۱ کیلومتر است؛ یعنی تصادفهای شبانه حدود ۵۰ درصد پراکندهترند».
⏱️ نمایش تغییرات زمانی با Time Slider
اگر Case Field شما سال یا تاریخ است، میتوانید خروجی Mean Center و بیضیها را متحرک کنید. در خروجی، فیلد Case (مثلاً Year) را به یک فیلد تاریخ تبدیل کنید (با Calculate Field یا Convert Time Field)، سپس در Layer Properties، صفحهی Time، گزینهی Layer Time را روی Each feature has a single time field بگذارید و همان فیلد را انتخاب کنید. با فعال شدن زبانهی Time در ریبون، Time Slider نقشه ظاهر میشود و با پخش آن، جابهجایی مرکز و چرخش بیضی سالبهسال دیده میشود. این انیمیشن را میتوانید از زبانهی Animation به ویدیو خروجی بگیرید و در ارائهها استفاده کنید؛ مدیران معمولاً یک انیمیشن دهثانیهای را بهتر از ده جدول به خاطر میسپارند.
🐍 اجرای سریع با Python
import arcpy
arcpy.env.workspace = r"C:\GIS\Safety.gdb"
arcpy.env.overwriteOutput = True
fc = "Accidents_UTM"
arcpy.stats.MeanCenter(fc, "Acc_MeanCenter", "Injured", "Year")
arcpy.stats.MedianCenter(fc, "Acc_MedianCenter", "Injured", "Year")
arcpy.stats.CentralFeature(fc, "Acc_Central", "EUCLIDEAN_DISTANCE")
arcpy.stats.StandardDistance(fc, "Acc_StdDist", "1_STANDARD_DEVIATION", "Injured", "Year")
arcpy.stats.DirectionalDistribution(fc, "Acc_Ellipse", "1_STANDARD_DEVIATION", "Injured", "Year")
این اسکریپت پنج ابزار را با یک وزن و یک Case Field اجرا میکند؛ پایهی خوبی برای گزارش ماهانه یا سالانه است.
🧪 تمرین عملی: الگوی مکانی تصادفهای شهری
- ۱یک لایهی نقطهای تصادفها با فیلدهای
Year،DayNightوInjuredاز داده های آرک جی آی اس پرو بردارید یا با دستکم ۱۵۰ نقطه بسازید و به UTM تصویر کنید. - ۲Mean Center و Median Center کل داده را بسازید و فاصلهی دو مرکز را با Measure بسنجید.
- ۳Mean Center را با Case Field = Year و Weight = Injured بسازید و با Points To Line مسیر جابهجایی را رسم کنید.
- ۴Central Feature را اجرا کنید و نشان دهید کدام تصادف واقعی در مرکز قرار دارد.
- ۵Standard Distance را با Case Field = DayNight اجرا کنید و شعاع دو دایره را مقایسه کنید.
- ۶Directional Distribution را برای کل داده اجرا و نسبت محور بلند به کوتاه را با Calculate Field محاسبه کنید.
- ۷یک Layout با نقشه، جدول خلاصه و یک پاراگراف تفسیر بسازید.
💡 نکته
چکلیست موفقیت: همهی خروجیها روی دادهی تصویرشده ساخته شدهاند، مسیر سالها به ترتیب درست رسم شده، اختلاف Mean و Median تفسیر شده و تفسیر Standard Distance با واحد و مقایسه نوشته شده است. تمرینهای بیشتر در تمرین های آرک جی آی اس پرو.
🏙️ سناریوی واقعی: ردیابی جابهجایی مرکز تصادفات شهری در سه سال
پلیس راهور یک شهر دادهی نقطهای تصادفات سه سال اخیر را با فیلد تاریخ در اختیار دارد و میخواهد بداند آیا تمرکز تصادفات پس از افتتاح یک بزرگراه جدید جابهجا شده است. آمار فضایی توصیفی پاسخ را به شکلی ساده و قابل ارائه نشان میدهد:
- ۱با Calculate Field یک فیلد «سال» از روی فیلد تاریخ بسازید.
- ۲ابزار Mean Center را با فیلد سال در Case Field اجرا کنید تا برای هر سال یک مرکز میانگین ساخته شود.
- ۳ابزار Standard Deviational Ellipse را هم با همان Case Field اجرا کنید تا جهت و پراکندگی تصادفات هر سال دیده شود.
- ۴اگر تعداد مجروحان مهم است، همین تحلیل را با فیلد وزن (Weight Field) تکرار کنید و نتیجه را با حالت بدون وزن مقایسه کنید.
- ۵سه مرکز و سه بیضی را با رنگهای متمایز روی یک نقشه بگذارید و جهت جابهجایی را با یک فلش در صفحهآرایی نشان دهید.
💡 نکته
برای مقایسهی منصفانه بین سالها، مطمئن شوید نحوهی ثبت داده تغییر نکرده است. اگر از یک سال به بعد تصادفات خسارتی هم ثبت شدهاند، جابهجایی مرکز ممکن است ناشی از تغییر روش ثبت باشد نه تغییر واقعی الگو.
🐞 خطاهای رایج و راهحل
❓ پرسشهای متداول درباره آمار فضایی در ArcGIS Pro
🔹 آمار فضایی در ArcGIS Pro به چه لایسنسی نیاز دارد؟
ابزارهای سنجش توزیع جغرافیایی (Mean Center، Median Center، Central Feature، Standard Distance و Directional Distribution) در همهی سطوح لایسنس از جمله Basic در دسترساند.
🔹 تفاوت Mean Center و Central Feature چیست؟
Mean Center یک نقطهی فرضی با میانگین مختصات میسازد که ممکن است روی هیچ عارضهای نباشد. Central Feature یکی از عوارض موجود را که کمترین مجموع فاصله تا بقیه را دارد انتخاب و کپی میکند.
🔹 چه زمانی Median Center بهتر از Mean Center است؟
وقتی داده نامتقارن است یا دادهی پرت دارد. Median Center مجموع فاصله تا همهی عوارض را کمینه میکند و کمتر تحت تأثیر چند نقطهی دور قرار میگیرد.
🔹 Circle Size در Standard Distance را چه بگذارم؟
برای مقایسهی گروهها معمولاً ۱ انحراف معیار کافی و خواناتر است. اگر میخواهید بیشتر عوارض را دربرگیرد، ۲ انحراف معیار را انتخاب کنید و به یاد داشته باشید درصدهای ۶۸ و ۹۵ فقط برای توزیع نرمال برقرارند.
🔹 بیضی انحراف معیار چه اطلاعاتی میدهد؟
مرکز داده، پراکندگی در امتداد دو محور و زاویهی چرخش را میدهد. نسبت محور بلند به کوتاه نشان میدهد داده چقدر در یک جهت خاص کشیده شده است.
🔹 آیا این ابزارها نشان میدهند داده خوشهای است؟
خیر؛ این ابزارها توصیفیاند. برای آزمون معناداری خوشهبندی از Average Nearest Neighbor یا Spatial Autocorrelation و برای یافتن محل خوشهها از Hot Spot Analysis استفاده کنید.
🔹 چرا باید داده را پیش از تحلیل Project کنم؟
چون این ابزارها فاصله و مختصات را میانگینگیری میکنند و در سیستم جغرافیایی (درجه) یا Web Mercator فاصلهها تحریف میشوند. مستندات Esri برای محاسبهی دقیق، دادهی تصویرشده را لازم میداند.
🔹 آیا جابهجایی مرکز میانگین بهتنهایی نشاندهندهی تغییر معنادار است؟
نه. مرکز میانگین و بیضی انحراف معیار آمار توصیفیاند و آزمون معناداری انجام نمیدهند. برای سنجش معنادار بودن خوشهها یا تغییر الگو، از ابزارهایی مثل Hot Spot Analysis یا Emerging Hot Spot Analysis در جعبهابزار Spatial Statistics استفاده کنید.
🏁 جمعبندی
در این فصل با آمار فضایی در ArcGIS Pro توزیع جغرافیایی داده را اندازه گرفتیم: با Mean Center و Median Center مرکز داده را یافتیم، با Central Feature مرکزیترین عارضهی واقعی را انتخاب کردیم، با Standard Distance پراکندگی را سنجیدیم و با Directional Distribution جهت و کشیدگی را نشان دادیم. همچنین دیدیم Case Field و وزن چطور این ابزارها را به ابزار مقایسهی زمانی و گروهی تبدیل میکنند و گام بعدی، ابزارهای استنباطی و لکههای داغ است. در فصل پایانی وارد بعد سوم میشویم: فصل چهاردهم: تحلیل سه بعدی در ArcGIS Pro.
✅ نکات کلیدی این بخش
- داده را Project کنید
- Mean برای مقایسه، Median برای دادهی پرت، Central برای انتخاب
- Standard Distance و بیضی برای پراکندگی و جهت
- Case Field قدرت مقایسه میدهد
🗺️ ادامهی مسیر آموزش ArcGIS Pro
→ فصل قبل: تحلیل مجاورت در آرکجیایاس پرو
🎓 اگر میخواهید این مباحث را با دادهی واقعی، تمرین تصحیحشده و پشتیبانی مدرس یاد بگیرید، سرفصل دوره آرک جی آی اس پرو گیسلند را ببینید. برای نصب نرمافزار هم راهنمای نصب آرک جی آی اس پرو و برای منابع مطالعهی بیشتر صفحهی کتاب آرک جی آی اس پرو را ببینید.
🔗 مطالب پایهی مرتبط: آشنایی با رابط کاربری ArcGIS Pro، ساخت پروژه در ArcGIS Pro، افزودن داده در ArcGIS Pro و پیمایش نقشه و بوکمارک در ArcGIS Pro.
📖 منابع: مستندات رسمی Esri: Mean Center tool و Directional Distribution tool.
📕 مطالعهی بیشتر: موضوعبندی این مطلب از فصل ۱۳ کتاب ArcGIS Pro 3.x Cookbook (ویرایش دوم)، نوشتهی Tripp Corbin، انتشارات Packt، ۲۰۲۴ الهام گرفته است؛ متن، مراحل و مثالها نوشتهی اختصاصی گیسلند هستند.


بدون دیدگاه